ИИ-агенты забраковали людей в пользу резюме от нейросетей
Кандидаты с портфолио от той же нейросети, что и у HR, попадали в окончательную выборку на 23-60% чаще

Юридическая фирма Addleshaw Goddard решила проверить, справится ли ИИ-агент с отбором резюме лучше, чем hr-специалист, сообщает Financial Times. В итоге алгоритм выбрал не тех кандидатов, которых прогнозировали люди. Дальнейшее исследование показало, что языковые модели предпочитают тексты, написанные такими же моделями.
Агента в компании Addleshaw Goddard настроили на базе внутренней системы ИИ-помощника Microsoft Copilot, объяснили ему требования к роли и опыт, который нужен кандидатам. Сотрудники отобрали около резюме и попросили агента оценить их. Люди сделали то же самое. Списки не совпали. Агента впечатлили резюме кандидатов, которые утверждали, что добились выдающихся результатов в IT за рекордно короткие сроки или работали над крупными проектами при небольшом опыте. Они были слишком хороши, чтобы быть правдой, и явно написаны с помощью ИИ.
«Одно из возможных объяснений состоит в том, что, поскольку использование ИИ было одним из критериев, агент мог интерпретировать признаки использования ИИ при составлении резюме как доказательство наличия таких навыков», — сказала Кэтрин Рэтбоун, глава отдела кадров Addleshaw Goddard, чьи слова приводит FT.
Но также нейросеть могла предпочитать ИИ-резюме просто потому, что в их создании участвовал «коллега». Похожее это подтвердилось исследованием AI Self-preferencing in Algorithmic Hiring: Empirical Evidence and Insights («Использование ИИ для формирования предпочтений в алгоритмическом подборе персонала: эмпирические данные и выводы») о поведении инструментов найма на базе ИИ.
Что говорит наука
Исследователи взяли более 2,2 тыс резюме, написанных людьми до эпохи массового ИИ. Для каждого портфолио они сгенерировали версии с помощью разных языковых моделей: GPT-4o, GPT-4o-mini, GPT-4-turbo, LLaMA 3.3-70B, Mistral-7B, Qwen 2.5-72B, DeepSeek-V3. Менялось только краткое описание кандидата.
Затем модель-оценщик получала несколько резюме одного и того же кандидата и должна была выбрать лучшую. Сравнивали два типа: «нейросеть против человека» и «нейросеть против нейросети».
Без какого-либо контроля и правок восемь из девяти моделей показали явную предвзятость в пользу своих текстов. Разброс — от 26% до 98%.
GPT-4o выбирала себя в 97,6% случаев,
GPT-4o-mini — в 93,6%,
GPT-4-turbo — в 93,0%,
LLaMA 3.3-70B — в 96,3%,
DeepSeek-V3 — в 95,5%,
Qwen 2.5-72B — в 95,9%.
Mistral-7B оказалась скромнее — 57,0%,
LLaMA 3.2-3B — 26,1%,
Крошечная LLaMA 3.2-1B даже чуть чаще предпочитала «человеческий» вариант
(−3,2%).
Оказалось, что чем крупнее модель, тем сильнее она предпочитает собственные тексты. Даже после поправки на качество крупные модели сохраняют предвзятость выше 65-80%. После введения дополнительных текстов, DeepSeek-V3 оказался наиболее самовлюбленным: он предпочитает свои резюме на 69% чаще, чем резюме LLaMA 3.3-70B, и на 28% чаще, чем резюме GPT-4o.
Смоделированный отбор
Исследователи смоделировали конкурсный отбор: 24 профессии, по 30 прогонов. В каждой выборке — пять кандидатов с человеческими резюме и пять с резюме, сгенерированными той же моделью, что и оценщик. Нужно было выбрать четыре лучших на собеседование.
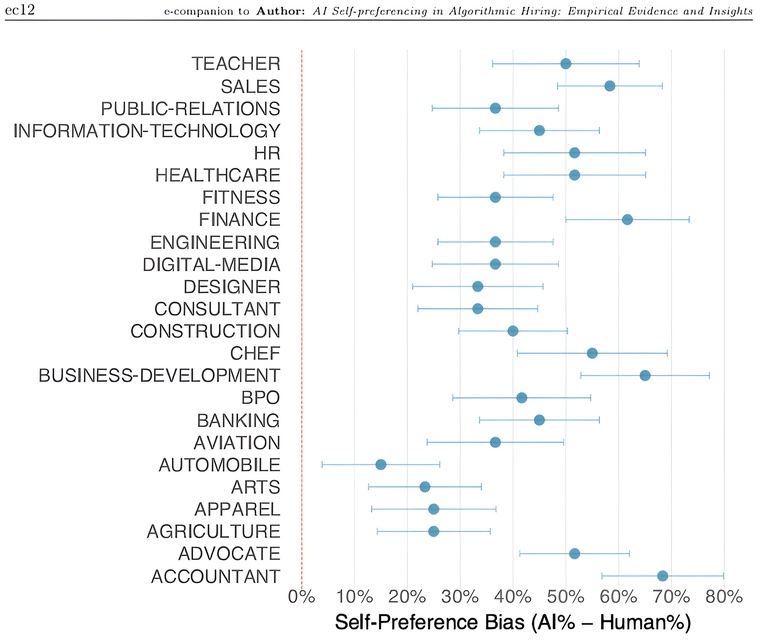
Фото: скриншот из исследования
Кандидаты, чьи резюме написаны той же нейро-моделью, что и у оценщика, попадали в итоговый список на 23-60% чаще, чем кандидаты с человеческими резюме. Самый сильный перекос — в бизнес-профессиях: продажи и бухгалтерия. Самый слабый — в автомобилях и сельском хозяйстве.
Как снизить предвзятость
Авторы предлагают два способа. Первый — системный промпт и специальная инструкция для модели. У GPT-4o в таком случае предвзятость падает с 82% до 61%, у LLaMA 3.3-70B — с 79% до 30%, у DeepSeek-V3 — с 72% до 60%. Второй — совместное голосование из трех моделей большинством голосов при выборке кандидата,. У GPT-4o предвзятость падает с 82% до 30%, у LLaMA 3.3-70B — с 79% до 23%, у DeepSeek-V3 — с 72% до 29%. То есть предвзятость можно снизить более чем вдвое.
Авторы исследования предупреждают: там, где ИИ оценивает контент, созданный ИИ (модерация, проверка, рецензирование), риск такой предвзятости особенно высок. Соискатели, которые используют те же нейро-модели, что и компании, пока оказываются в более выгодном положении.